
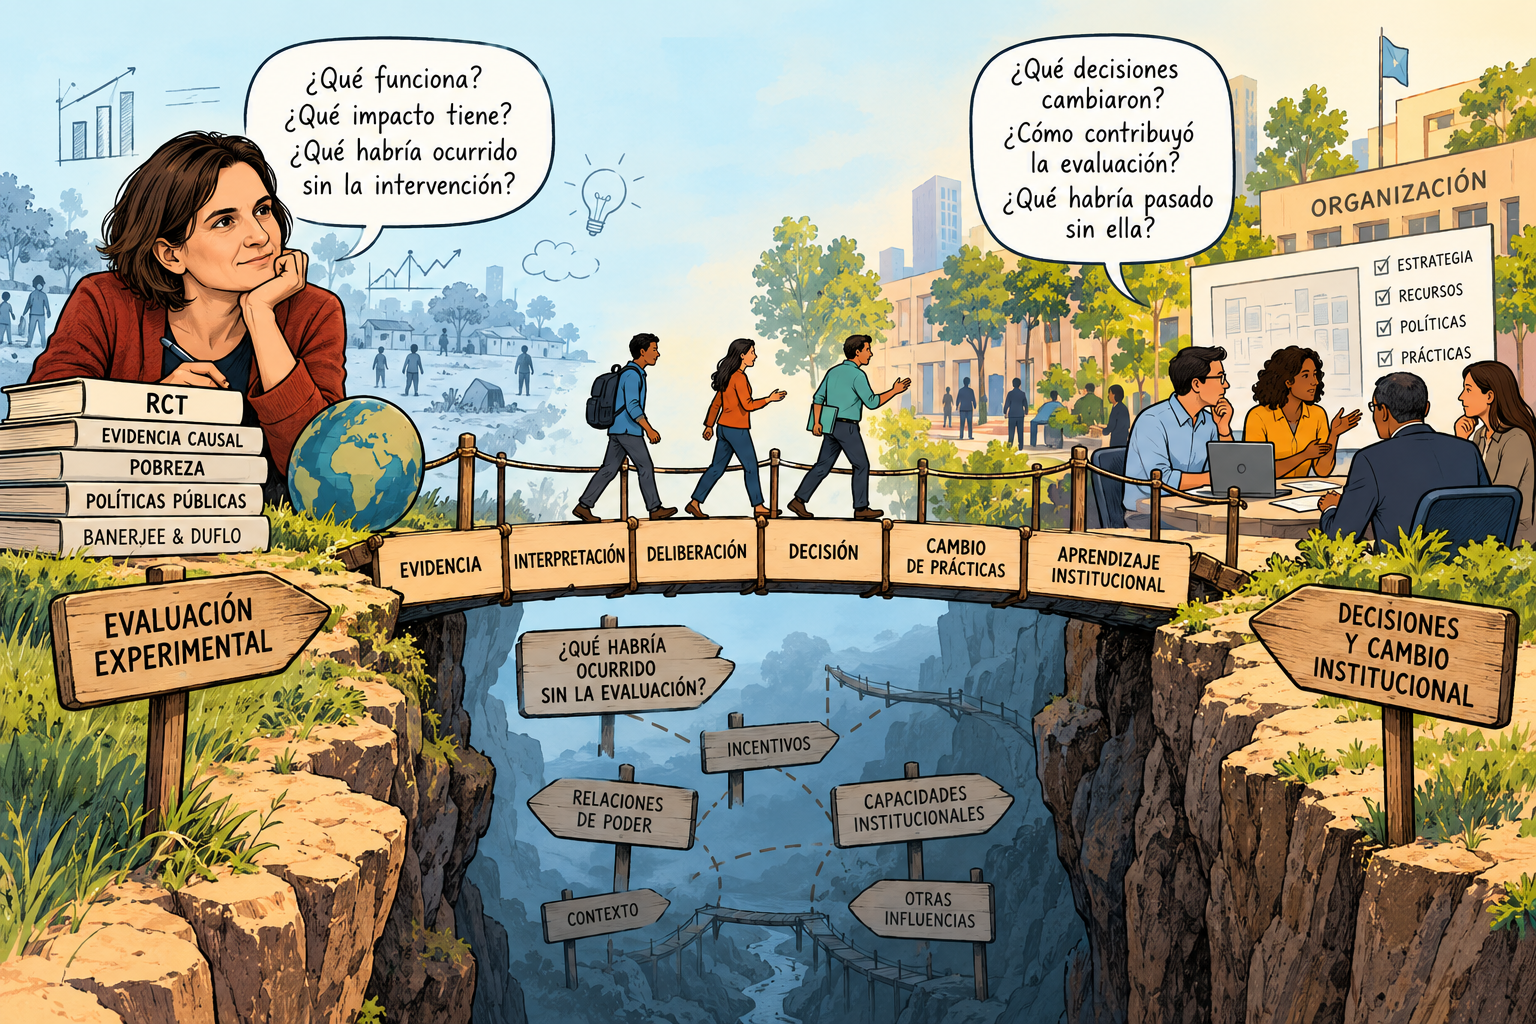
De Esther Duflo al contrafactual del aprendizaje institucional
¿Y si aplicáramos a nuestras propias evaluaciones la misma exigencia causal que pedimos a los programas que evaluamos? Este artículo propone trasladar la lógica del contrafactual desde los efectos de las intervenciones hacia la influencia de las evaluaciones sobre las decisiones, el aprendizaje y el cambio institucional. Porque una cosa es demostrar qué funciona y otra, bastante diferente, conseguir que ese conocimiento cambie algo.
La revolución de Duflo y una pregunta incómoda
En 2019, Esther Duflo recibió el Nobel de Economía, junto con Abhijit Banerjee y Michael Kremer, por su contribución al enfoque experimental para combatir la pobreza. Su trabajo ayudó a consolidar una pregunta fundamental en la evaluación de impacto: ¿cómo sabemos que una intervención produce realmente los resultados que le atribuimos?
La respuesta pasa por construir un contrafactual creíble: ¿qué habría ocurrido si la intervención no hubiera existido?
Los ensayos controlados aleatorizados (RCT) han contribuido decisivamente a responder esta pregunta, permitiendo identificar efectos causales con un rigor difícil de alcanzar mediante simples comparaciones entre beneficiarios y no beneficiarios (Banerjee & Duflo, 2009).
En Poor Economics, Banerjee y Duflo (2011) muestran, además, cómo la experimentación puede cuestionar ideas ampliamente aceptadas sobre la pobreza y orientar intervenciones más eficaces.
Pero identificar un efecto causal no resuelve todas las preguntas.
Un programa puede funcionar en un contexto y fracasar en otro. Un efecto promedio puede ocultar diferencias importantes entre grupos. Y una intervención puede producir resultados inmediatos sin transformar las instituciones que deberían sostenerlos.
En TripleAD abordé recientemente estas cuestiones al explorar cómo el Causal Machine Learning permite analizar la heterogeneidad de efectos y avanzar desde el clásico «¿funciona?» hacia preguntas más interesantes: ¿para quién funciona, en qué circunstancias y con qué implicaciones? (Rodríguez-Ariza, 2026a).
Sin embargo, hay otra frontera que me interesa todavía más.
Podemos perfeccionar indefinidamente nuestra capacidad para demostrar qué funciona sin mejorar necesariamente nuestra capacidad para utilizar ese conocimiento.
Y aquí aparece una pregunta algo incómoda para quienes nos dedicamos a evaluar:
¿Qué habría ocurrido si nuestra evaluación no se hubiera realizado?
No me refiero a si tendríamos un informe menos, unas recomendaciones pendientes o una presentación menos en el calendario institucional.
Me refiero a algo bastante más difícil: ¿habría tomado la organización decisiones diferentes? ¿Habría modificado sus prioridades, reasignado recursos, cuestionado sus supuestos o cambiado alguna de las estructuras responsables de los problemas identificados?
Quizá haya llegado el momento de aplicar a la propia evaluación una parte de la exigencia causal que pedimos a los programas que evaluamos.
El contrafactual olvidado
En 2017, al reflexionar sobre cómo potenciar el uso de las evaluaciones, planteaba la necesidad de explicitar la teoría del cambio del propio proceso evaluativo: cómo una evaluación podía contribuir al uso del conocimiento, al aprendizaje y a la toma de decisiones (Rodríguez-Ariza, 2017).
Casi diez años después, la pregunta sigue vigente. Aunque quizá podamos formularla de manera más exigente.
La literatura lleva décadas recordándonos que producir evidencia no garantiza su utilización. Patton (2008) situó a los usuarios y los usos previstos en el centro del diseño evaluativo. Weiss (1998) mostró que la influencia de una evaluación no se limita a decisiones inmediatas, sino que también puede manifestarse en nuevas ideas y formas de interpretar los problemas. Kirkhart (2000) amplió todavía más esta perspectiva, proponiendo entender la influencia evaluativa según su origen, intencionalidad y evolución temporal.
Por tanto, no estamos descubriendo que las evaluaciones deben utilizarse. Eso ya lo sabemos.
Lo interesante sería llevar esta preocupación un paso más allá.
Imaginemos dos organizaciones que reciben evidencia igualmente rigurosa sobre la ineficacia de una intervención.
La primera revisa su estrategia, modifica incentivos y reasigna recursos.
La segunda reconoce las recomendaciones, prepara una respuesta de gestión, actualiza su sistema de seguimiento y continúa trabajando prácticamente igual.
Ambas pueden demostrar que han respondido a la evaluación. Pero ¿han aprendido lo mismo?
La diferencia no está necesariamente en la calidad de la evidencia. Puede encontrarse en quién tiene autoridad para decidir, qué incentivos condicionan las decisiones, qué relaciones permiten cuestionar supuestos o qué consecuencias institucionales tiene reconocer que algo no funciona.
Esto conecta con una preocupación recurrente de TripleAD: las organizaciones pueden identificar reiteradamente los mismos problemas sin conseguir modificar los mecanismos que los reproducen (Rodríguez-Ariza, 2026b).
De ahí surge una hipótesis que merece ser explorada:
La influencia de una evaluación depende tanto de la calidad de la evidencia producida como de las condiciones institucionales que permiten convertirla en decisiones y cambios.
No se trata de restar importancia al rigor metodológico. Todo lo contrario. Se trata de reconocer que el rigor de la evidencia y la capacidad institucional para utilizarla son dos dimensiones diferentes de un mismo desafío.
¿Y si la evaluación tuviera su propia teoría del cambio?
Si aceptamos que una evaluación constituye también una intervención sobre un sistema de decisiones, deberíamos poder identificar qué cambios esperamos que produzca y mediante qué mecanismos.
Podríamos entonces trabajar con dos teorías del cambio complementarias.
La primera explicaría cómo el programa pretende producir resultados.
La segunda explicaría cómo la evaluación pretende influir sobre las decisiones, las prácticas y el aprendizaje institucional.
Esta segunda teoría podría seguir una secuencia aparentemente sencilla:
Evidencia → interpretación → deliberación → decisión → cambio de prácticas → aprendizaje institucional.
Pero sabemos que las organizaciones rara vez funcionan de manera tan ordenada.
Entre cada eslabón intervienen mecanismos concretos: confianza, legitimidad, autoridad, incentivos, recursos, relaciones de poder y oportunidades políticas. La evidencia puede ser ignorada, reinterpretada, instrumentalizada o utilizada de maneras que nunca imaginamos.
Precisamente por eso, la teoría del cambio de una evaluación no debería limitarse a describir cómo esperamos que se utilicen sus recomendaciones. Debería ayudarnos a investigar qué sucede realmente.
Podríamos preguntarnos:
- ¿Qué decisiones cambiaron a partir de los hallazgos?
- ¿Quién utilizó la evidencia, cómo y para qué?
- ¿Qué habría ocurrido razonablemente sin la evaluación?
- ¿Qué condiciones facilitaron o impidieron los cambios?
- ¿Qué transformaciones persistieron más allá del seguimiento formal de recomendaciones?
No siempre podríamos responder mediante un RCT. Y tampoco sería necesario.
El análisis de contribución, por ejemplo, permite construir explicaciones causales creíbles mediante teorías del cambio, evidencia empírica y el examen de explicaciones alternativas (Mayne, 2012). El process tracing y las comparaciones entre casos también pueden ayudarnos a comprender cómo una evaluación contribuyó —o no— a determinadas decisiones.
La cuestión no es atribuir mecánicamente cada decisión a una evaluación, sino investigar su influencia con el mismo espíritu crítico que aplicamos al análisis de los programas.
Y aquí conviene introducir una distinción importante.
Una recomendación implementada no equivale necesariamente a una decisión transformada.
Puede representar un cambio significativo. O simplemente una actividad administrativa que permite cerrar una casilla.
Los sistemas de seguimiento de respuestas de gestión son necesarios, pero no deberían convertirse en sustitutos del análisis del uso y la influencia de las evaluaciones.
Tres contrafactuales para pensar la evaluación
Quizá podamos ordenar esta reflexión distinguiendo tres preguntas complementarias.
El contrafactual del programa: ¿qué habría ocurrido sin la intervención?
Es la pregunta clásica de la evaluación de impacto. Nos permite investigar los efectos causales de una intervención y distinguirlos de otros factores.
El contrafactual de la evaluación: ¿qué habría ocurrido sin la evaluación?
Nos invita a examinar si la evaluación contribuyó a modificar decisiones, interpretaciones, prioridades o prácticas institucionales.
El contrafactual institucional: ¿qué habría ocurrido si la organización hubiera tenido otras capacidades, incentivos o estructuras para aprender?
Esta tercera pregunta es particularmente interesante. Desplaza la atención desde la calidad de la evaluación hacia las condiciones que hacen posible —o dificultan— su influencia.
No son tres contrafactuales igualmente fáciles de construir ni de verificar. El tercero, especialmente, tiene un carácter más exploratorio y puede requerir comparaciones entre organizaciones, análisis de mecanismos y escenarios alternativos plausibles.
Pero juntos ofrecen una perspectiva útil: no basta con investigar si una intervención funciona; también necesitamos comprender si la evaluación influye y por qué algunas organizaciones son más capaces que otras de transformar la evidencia en acción.
De producir evidencia a transformar decisiones
Esta reflexión adquiere una relevancia particular en un momento en que la inteligencia artificial está ampliando extraordinariamente nuestras capacidades para producir y analizar información.
Podemos procesar grandes volúmenes de datos, identificar patrones, explorar efectos heterogéneos y automatizar tareas que antes requerían semanas de trabajo.
Pero ninguna sofisticación metodológica garantiza que una organización quiera, pueda o se atreva a cambiar.
Como planteaba al reflexionar sobre el futuro de la evaluación y la inteligencia artificial (Rodríguez-Ariza, 2026c), el valor añadido de nuestra profesión no puede reducirse a producir información cada vez más sofisticada. También reside en construir juicios fundamentados, facilitar la deliberación y contribuir a decisiones mejor informadas.
Quizá necesitemos complementar nuestros sistemas de aseguramiento de calidad metodológica con una atención mucho mayor a las condiciones institucionales para utilizar la evidencia.
No para responsabilizar a los evaluadores de decisiones que no controlan. Tampoco para reducir el valor de una evaluación a cambios inmediatos y fácilmente medibles.
Una evaluación puede contribuir a cuestionar supuestos, abrir debates, modificar interpretaciones o fortalecer capacidades sin provocar una decisión claramente atribuible. Estas formas de influencia también importan.
Pero precisamente porque importan, deberíamos intentar comprenderlas y documentarlas mejor.
La evaluación no termina cuando conseguimos demostrar convincentemente qué ha ocurrido. Su potencial transformador depende también de lo que las instituciones sean capaces de hacer con ese conocimiento.
Duflo nos ayudó a preguntar qué habría ocurrido sin una intervención.
Quizá haya llegado el momento de dirigir esa misma curiosidad causal hacia nuestra propia práctica.
Porque si una evaluación demuestra rigurosamente que un programa no funciona, pero la organización continúa haciendo exactamente lo mismo, tenemos dos problemas distintos.
Uno es el programa.
El otro, quizá, sea nuestro sistema de evaluación.
Y este segundo problema también merece ser evaluado.
Referencias
Banerjee, A. V., & Duflo, E. (2009). The experimental approach to development economics. Annual Review of Economics, 1, 151–178. https://doi.org/10.1146/annurev.economics.050708.143235
Banerjee, A. V., & Duflo, E. (2011). Poor economics: A radical rethinking of the way to fight global poverty. PublicAffairs.
Kirkhart, K. E. (2000). Reconceptualizing evaluation use: An integrated theory of influence. New Directions for Evaluation, 2000(88), 5–23. https://doi.org/10.1002/ev.1188
Mayne, J. (2012). Contribution analysis: Coming of age? Evaluation, 18(3), 270–280. https://doi.org/10.1177/1356389012451663
Patton, M. Q. (2008). Utilization-focused evaluation (4th ed.). SAGE Publications.
Rodríguez-Ariza, C. (2017, 28 de octubre). Potenciando el uso de la evaluación. TripleAD: Aprendiendo a Aprender para el Desarrollo. https://triplead.blog/2017/10/28/potenciando-el-uso-de-la-evaluacion/
Rodríguez-Ariza, C. (2018, 20 de diciembre). Dimensiones para el aprendizaje organizacional. TripleAD: Aprendiendo a Aprender para el Desarrollo. https://triplead.blog/2018/12/20/dimensiones-para-el-aprendizaje-organizacional/
Rodríguez-Ariza, C. (2026a, 9 de octubre). Cuando el promedio no basta: Causal Machine Learning y una nueva frontera para la evaluación. TripleAD: Aprendiendo a Aprender para el Desarrollo. https://triplead.blog/2026/10/09/cuando-el-promedio-no-basta-causal-machine-learning-y-una-nueva-frontera-para-la-evaluacion/
Rodríguez-Ariza, C. (2026b, 14 de octubre). ¿Cuántas veces (y por qué) necesitamos aprender la misma lección? TripleAD: Aprendiendo a Aprender para el Desarrollo. https://triplead.blog/2026/10/14/cuantas-veces-y-por-que-necesitamos-aprender-la-misma-leccion/
Rodríguez-Ariza, C. (2026c, 9 de julio). Inteligencia artificial y el futuro de la evaluación. TripleAD: Aprendiendo a Aprender para el Desarrollo. https://triplead.blog/2026/07/09/inteligencia-artificial-y-el-futuro-de-la-evaluacion/
Weiss, C. H. (1998). Have we learned anything new about the use of evaluation? American Journal of Evaluation, 19(1), 21–33. https://doi.org/10.1177/109821409801900103
Nota sobre el uso de inteligencia artificial: He utilizado herramientas de inteligencia artificial para explorar ideas, contrastar perspectivas, identificar referencias y mejorar la redacción. El enfoque, las reflexiones y las conclusiones son propios y de mi exclusiva responsabilidad.

