For years, we have invested in training evaluators, improving methodologies, organising conferences and strengthening institutions. Yet perhaps we have paid far less attention to something both simpler and more difficult: who brings all these efforts together once we return home?
A few days ago, I was talking with a colleague about evaluation. At some point, our conversation turned to the national evaluation association.
“There have been virtually no activities for nine years,” she told me.
I have not systematically examined the history of that particular association, so I take her comment for what it is: an observation, not evidence about the association itself. Still, her words stayed with me, perhaps because they point to a much wider problem.
While the international evaluation community organises increasingly sophisticated conferences, global initiatives, webinars, working groups and professional gatherings, what happens at country level between conferences?
Who keeps evaluators connected? Who brings together those who produce evaluations and those who should be commissioning them? Who connects government, universities, civil society, consultants, emerging evaluators and international organisations? Who sustains a national conversation about quality, ethics, professionalisation and evaluation use?
Perhaps we have devoted considerable attention to developing evaluation capacities, but far too little to developing the collective capacity of evaluation systems themselves.
Hemos invertido durante años en formar evaluador@s, mejorar metodologías, organizar conferencias y fortalecer instituciones. Quizá hemos prestado mucha menos atención a algo más sencillo y más difícil: quién conecta todo eso cuando volvemos a casa.
Hace unos días hablaba con una colega sobre evaluación. En algún momento de la conversación apareció la asociación nacional de evaluación.
—Hace nueve años que prácticamente no hay actividades —me dijo.
No he comprobado sistemáticamente la historia de esa asociación de evaluación nacional y, por tanto, tomo la conversación por lo que es: una observación, no evidencia sobre esa asociación naciónal. Pero la frase se me quedó dando vueltas porque quizá describe un problema bastante mayor.
Mientras las comunidades internacionales de evaluación organizan conferencias, iniciativas globales, webinars, grupos de trabajo y encuentros cada vez más sofisticados, ¿qué ocurre entre conferencia y conferencia en los países?
¿Quién mantiene conectados a los evaluadores? ¿Quién relaciona a quienes producen evaluaciones con quienes deberían demandarlas? ¿Quién conecta gobierno, universidad, sociedad civil, consultores, jóvenes evaluadores y organismos internacionales? ¿Quién sostiene una conversación nacional sobre calidad, ética, profesionalización y uso?
Quizá hemos dedicado mucha atención a desarrollar capacidades de evaluación y demasiado poca a desarrollar la capacidad colectiva del propio sistema de evaluación.
Muchas capacidades, ¿pero sistema?
No es una cuestión nueva.
Las Voluntary Organizations for Professional Evaluation (VOPEs) se expandieron enormemente durante las últimas décadas. EvalPartners las situó explícitamente como actores del desarrollo de capacidades nacionales de evaluación, capaces no sólo de fortalecer a los profesionales sino también de influir sobre decisores y favorecer entornos propicios para la evaluación (Kosheleva & Segone, 2013).
Sin embargo, el problema parece persistir.
Un estudio sobre VOPEs africanas encontró una paradoja reveladora: las asociaciones se han multiplicado, pero muchas continúan teniendo importantes limitaciones financieras y humanas. Los autores sostienen precisamente que deberían convertirse en pilares de los sistemas nacionales de evaluación, actuando tanto sobre la oferta como sobre la demanda de evaluación (Fish et al., 2022).
Una investigación comparativa todavía más reciente sobre asociaciones de Brasil, Ghana, Indonesia y Uganda encuentra problemas recurrentes de financiación y muestra además algo especialmente interesante: la profesionalización no sigue una trayectoria universal. Las asociaciones negocian continuamente su independencia, su relación con los gobiernos, su vinculación con la cooperación internacional y las tensiones entre modelos globales y contextos nacionales (Jersild, 2026).
Por tanto, tener una asociación no significa necesariamente tener una comunidad evaluativa activa. Y tener muchos evaluadores tampoco significa tener un sistema de evaluación.
Eso debería resultarnos familiar.
Del desarrollo de capacidades al desarrollo del sistema
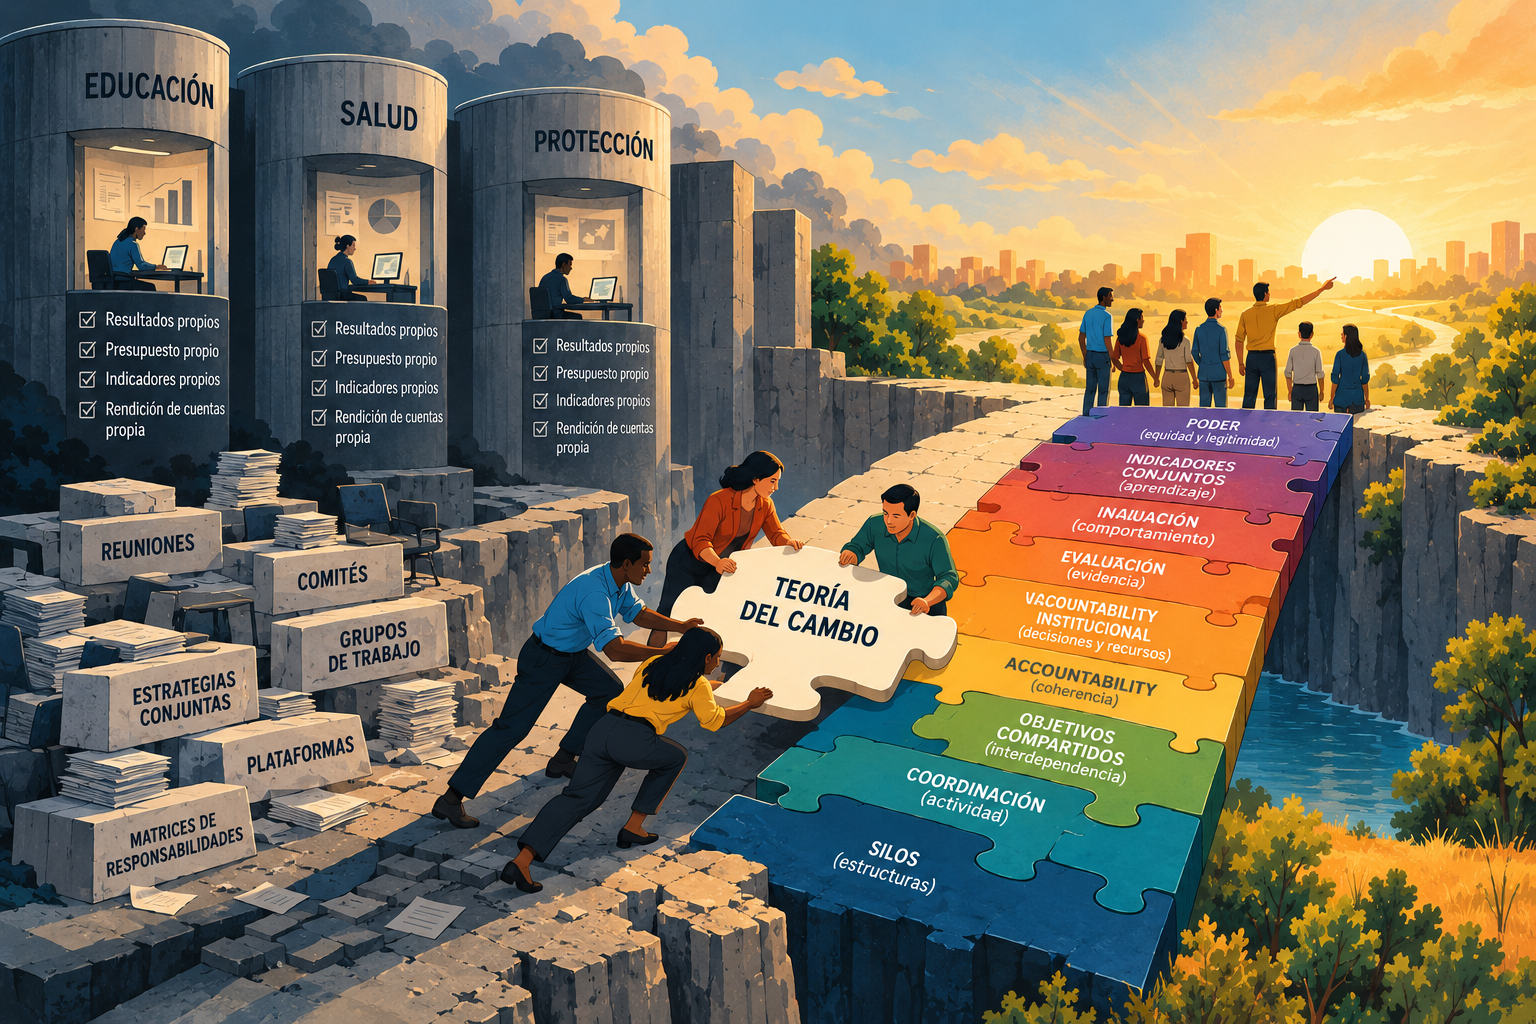
Cuando nuestras teorías del cambio prometen integración, pero nuestros sistemas de gestión premian trabajar por separado.
Quizá no necesitamos más reuniones: necesitamos cambiar aquello por lo que rendimos cuentas: De los silos al impacto colectivo: cuando nuestras teorías del cambio prometen integración, pero nuestros sistemas de gestión siguen premiando la fragmentación.
De los silos al impacto colectivo: cuando nuestras teorías del cambio prometen integración, pero nuestros sistemas de gestión siguen premiando la fragmentación.
Hay observaciones de una evaluación que siguen dando vueltas después de cerrar el informe. Hace poco me ocurrió con una: abundaban las reuniones, los grupos temáticos y las iniciativas de convergencia, pero persistían las dificultades para trabajar transversalmente.
Quizá el problema no estaba principalmente en las personas.
Quizá estaba en el marco de resultados.
¿Estamos intentando producir colaboración mediante reuniones mientras nuestros sistemas de gestión hacen racional trabajar por separado?
Una pregunta que lleva años esperando respuesta
En TripleD llevamos volviendo sobre la coordinación, la colaboración y el impacto colectivo. En ¿Por qué no nos coordinamos? ya planteaba una teoría del cambio basada en liderazgo, confianza, capacidades, incentivos y responsabilidad mutua (Rodríguez-Ariza, 2017).
Después exploré las condiciones del trabajo colaborativo, sus conductores y los desincentivos que enfrentan las organizaciones (Rodríguez-Ariza, 2018, 2019).
La síntesis de 2025 reunía esas reflexiones: colaborar no es simplemente coordinar actividades, sino construir interdependencia real para conseguir resultados que nadie alcanzaría individualmente.
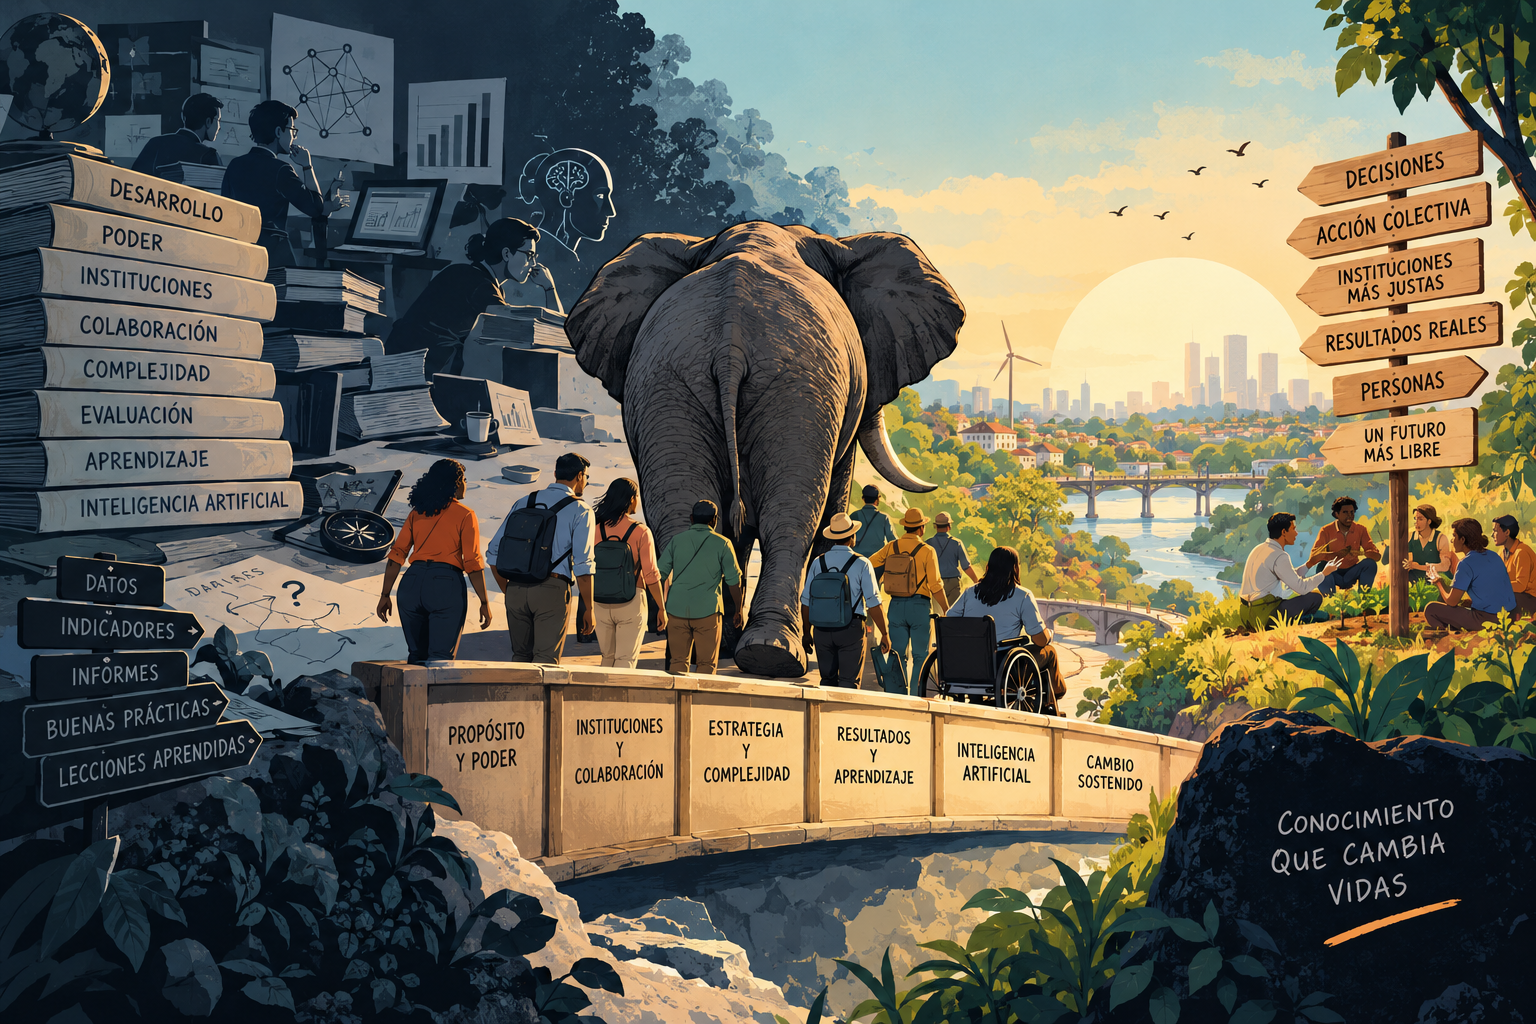
Del poder a los indicadores, de las instituciones a las personas: por qué el verdadero desafío del desarrollo es transformar conocimiento en acción colectiva.
Hay algo desconcertante en el mundo del desarrollo. Nunca hemos tenido tantas estrategias, evaluaciones, indicadores, teorías del cambio y herramientas para gestionar conocimiento. Sin embargo, seguimos encontrándonos con problemas extraordinariamente parecidos: instituciones que no colaboran, recomendaciones que nadie utiliza, proyectos que desaparecen cuando termina la financiación y organizaciones que aprenden repetidamente las mismas lecciones.
¿Y si nuestro principal problema no fuera la falta de conocimiento, sino nuestra limitada capacidad colectiva para convertirlo en decisiones y transformaciones sostenidas?
Esta pregunta conecta buena parte de las preocupaciones que han recorrido TripleAD: desarrollo, instituciones, poder, coordinación, complejidad, evaluación, aprendizaje e inteligencia artificial.
Del desarrollo que queremos al poder para decidirlo
La paradoja de las evaluaciones que producen conocimiento sin transformar las instituciones
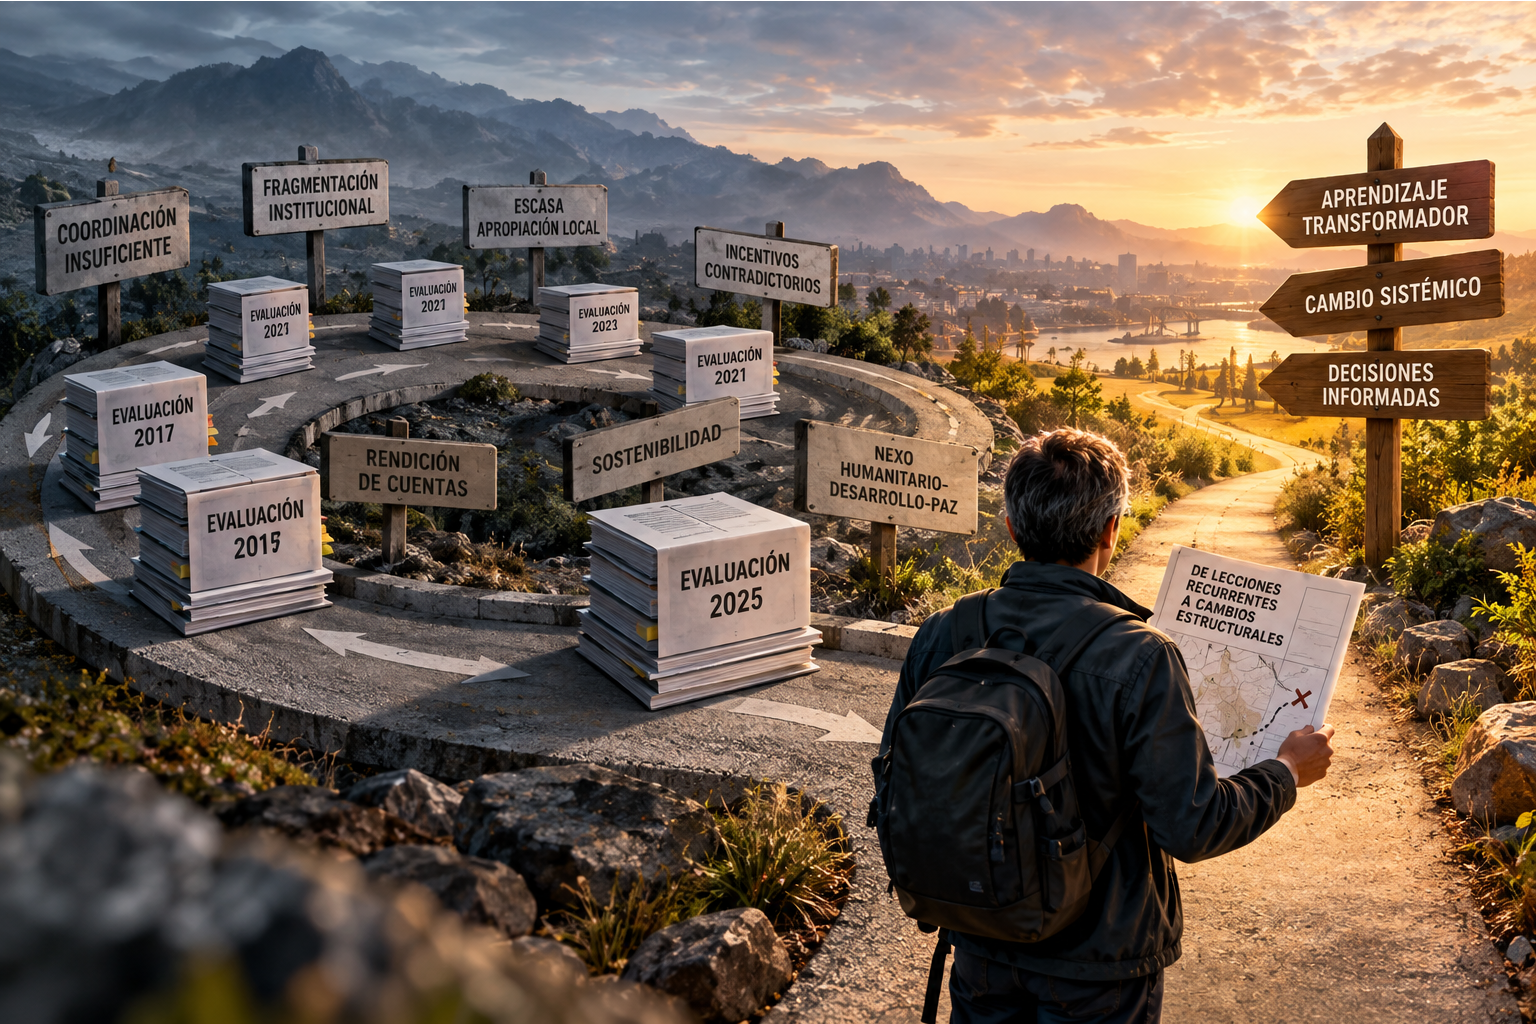
Hay algo desconcertante en el mundo de la evaluación: llevamos décadas identificando problemas, documentando lecciones y formulando recomendaciones. Y, sin embargo, seguimos encontrándonos con dificultades extraordinariamente similares.
Fragmentación institucional. Coordinación insuficiente. Escasa apropiación local. Incentivos contradictorios. Debilidades en la sostenibilidad. Dificultades para conectar la acción humanitaria con el desarrollo y la paz.
La lista resulta familiar. Quizás demasiado familiar.
¿Estamos realmente aprendiendo? ¿O hemos construido un sofisticado sistema para producir conocimiento sin transformar suficientemente las estructuras que generan los problemas?
Diez años de evaluaciones. ¿Diez años de aprendizaje?
Una invitación a un encuentro organizado por la OCDE, la Comisión Europea y el grupo de evaluaciones humanitarias interinstitucionales, previsto para el 20 de octubre de 2026, me hizo recuperar esta inquietud.
¿Qué ocurre cuando un programa que “no funciona” en promedio produce, sin embargo, resultados muy diferentes para distintos grupos? El Causal Machine Learning abre una posibilidad particularmente sugerente para la evaluación: pasar de preguntarnos simplemente “¿funciona?” a preguntarnos “¿qué funciona, para quién y bajo qué condiciones?”.
Durante décadas, una de las preguntas centrales de la evaluación de impacto ha sido aparentemente sencilla:¿funciona el programa?
Detrás de ella existe una sofisticada arquitectura metodológica. Ensayos controlados aleatorios, regresiones discontinuas, diferencias en diferencias y otros diseños intentan identificar de manera creíble qué cambios pueden atribuirse a una intervención.
Pero existe un problema menos visible: frecuentemente terminamos resumiendo toda esa complejidad mediante un efecto promedio.
Y los promedios pueden ocultar historias muy diferentes.
Imaginemos un programa social cuyo impacto medio sea prácticamente cero. Podríamos concluir que “el programa no funciona”. Sin embargo, detrás de ese cero podrían coexistir efectos positivos importantes para algunos grupos, efectos pequeños para otros y efectos negativos para otros.
El promedio puede ser correcto. Pero puede no ser suficiente para tomar una buena decisión.
Del “¿funciona?” al “¿para quién funciona?”
Aquí aparece una de las conexiones más interesantes entre evaluación e inteligencia artificial: el Causal Machine Learning (CML).
El problema de partida es muy concreto. Los gobiernos pueden disponer de evidencia sobre si determinados programas funcionan en promedio y, sin embargo, saber mucho menos sobre qué funciona, para quién, bajo qué condiciones y a qué coste (UNICEF, 2026: p. 1).
El Causal Machine Learning intenta profundizar precisamente en esa heterogeneidad.
La irrupción de la inteligencia artificial ha abierto un intenso debate sobre el futuro de la evaluación. En pocos meses han aparecido herramientas capaces de transcribir entrevistas, sintetizar cientos de documentos, analizar información cualitativa, redactar informes o incluso proponer recomendaciones preliminares. La pregunta parece inevitable: ¿acabará la inteligencia artificial sustituyendo a l@s evaluador@s? Creo que esa formulación nos conduce por un camino equivocado. Como ocurre con las grandes transformaciones tecnológicas, la IA no solo modifica nuestras herramientas; también cuestiona las categorías con las que entendíamos nuestra propia práctica. Su principal impacto no es tecnológico, sino epistemológico. Más que preguntarnos qué tareas podrán realizar los algoritmos, deberíamos preguntarnos qué significa realmente evaluar cuando producir información deja de ser el principal problema.
Esta cuestión conecta con una reflexión que he desarrollado en varios artículos recientes de TripleAD. En Rediseñando la Evaluación como Sistema Efectivo defendía que la evaluación contemporánea ya no enfrenta una crisis metodológica, sino una crisis de relevancia institucional. Disponemos de más métodos, más datos y más capacidades analíticas que nunca, pero seguimos encontrando dificultades para que la evidencia influya de forma sistemática en las decisiones públicas. La fragmentación institucional, los incentivos limitados para aprender, la ritualización de muchos procesos evaluativos y la desconexión entre evidencia y decisión pesan hoy mucho más que cualquier limitación técnica. La llegada de la inteligencia artificial no contradice este diagnóstico; lo confirma de manera inesperada.
Durante buena parte de los últimos cincuenta años, la disciplina ha estado dominada por un paradigma metodológico. Desde Campbell y Cronbach hasta los enfoques participativos, sistémicos o basados en principios, el esfuerzo intelectual se concentró en fortalecer la calidad de los diseños, mejorar la validez de la evidencia y perfeccionar las herramientas disponibles (Campbell, 1999; Cronbach, 1980; Patton, 2021). Esa evolución permitió consolidar la evaluación como disciplina y elevar considerablemente sus estándares de calidad. Sin embargo, contenía un supuesto que raramente cuestionamos: que producir mejor evidencia conduciría, casi de forma automática, a mejores decisiones.
La inteligencia artificial pone precisamente ese supuesto en cuestión. Resulta revelador que las primeras tareas que consigue automatizar con mayor eficacia sean aquellas que durante décadas identificamos con el núcleo del trabajo evaluativo: organizar información, resumir documentos, codificar entrevistas, detectar patrones, comparar teorías del cambio o redactar informes. Cuanto más competentes se vuelven estos sistemas, más evidente aparece una paradoja difícil de ignorar: la evaluación nunca consistió realmente en hacer esas tareas. Lo que la inteligencia artificial automatiza no es la evaluación; automatiza aquellas actividades que durante demasiado tiempo confundimos con ella.
La consecuencia es mucho más profunda de lo que parece. Durante décadas respondimos a la pregunta equivocada. Pensábamos que el principal desafío consistía en producir mejor evidencia cuando, en realidad, el problema siempre fue cómo transformar esa evidencia en decisiones útiles. La IA no inaugura una nueva etapa de la evaluación; clausura definitivamente el paradigma metodológico que dominó la disciplina durante el último medio siglo. Precisamente porque automatiza aquello que considerábamos nuestro principal valor añadido, nos obliga a redescubrir cuál ha sido siempre el verdadero objeto de la evaluación.
Para comprender este cambio conviene distinguir conceptos que con frecuencia utilizamos como si fueran equivalentes. Los datos describen hechos; la información organiza esos datos; la evidencia permite fundamentar afirmaciones razonables. La evaluación, sin embargo, incorpora un nivel distinto de construcción del conocimiento: el juicio. Evaluar nunca ha consistido únicamente en responder qué ocurrió. Significa interpretar por qué ocurrió, para quién, bajo qué condiciones, respecto de qué valores y qué implicaciones deberían derivarse para las decisiones futuras. Esa diferencia parece sutil, pero transforma completamente la naturaleza de la disciplina.
Reimaginar la evaluación en tiempos de cambio: De la fatiga metodológica a la arquitectura del impacto
Bajada
La evaluación no enfrenta solo un problema de métodos. En un mundo más interdependiente, incierto y disputado, su desafío central es rediseñarse como sistema: más conectada con políticas y planificación, más colaborativa, más capaz de integrar enfoques transversales, más abierta a redistribuir poder y más sostenida por instituciones que cuidan, aprenden y usan evidencia.
La evaluación atraviesa una paradoja incómoda: nunca hemos tenido tantas herramientas, datos y metodologías, y sin embargo su influencia real en decisiones públicas sigue siendo limitada. El problema ya no es técnico. Es más profundo: es una crisis de diseño, de relevancia y de sentido.
Durante décadas, el campo se apoyó en un paradigma tecnocrático basado en medición, estandarización y rendición de cuentas. Ese modelo produjo avances importantes, pero hoy muestra límites evidentes: ritualización, fragmentación, baja utilización y desconexión con los procesos reales de decisión (Dahler-Larsen, 2012; Bamberger et al., 2019). Al mismo tiempo, los problemas públicos son cada vez más complejos, interdependientes y políticamente disputados, lo que ha reabierto el debate sobre el papel real de la evaluación en la toma de decisiones (OECD, 2023).
Sin embargo, como se ha argumentado recientemente, la evaluación sigue operando en muchos contextos como si el mundo fuera lineal, sectorial y estable (Rodríguez-Ariza, 2025a).
Por eso, el giro que hoy necesitamos no consiste en mejorar la evaluación como práctica aislada, sino en reimaginarla como sistema.
A lo largo de este artículo se desarrollan seis ideas conectadas:
(1) el problema es de diseño, no de métodos;
(2) la colaboración es infraestructura, no valor;
(3) la evaluación sigue siendo sectorial en un mundo interdependiente;
(4) evaluar hoy implica redistribuir poder;
(5) sin cuidado no hay sistema sostenible;
(6) el cambio real es pasar del individuo al sistema.
En conjunto, estas ideas apuntan a una tesis clara:
la evaluación solo será relevante si se convierte en una arquitectura institucional de aprendizaje, decisión y transformación, conectada con políticas, planificación y enfoques cross-sectoriales.
Cómo integrar género, equidad, participación y salvaguarda en el desarrollo
Durante las últimas décadas, las agencias de desarrollo han ido incorporando progresivamente lo que solemos llamar enfoques transversales: género, equidad, participación, salvaguarda o protección frente al abuso.
Hoy es difícil encontrar una organización internacional —desde agencias de Naciones Unidas hasta ONGs o bancos multilaterales— que no tenga políticas, guías o marcos operativos dedicados a estos temas.
Y, sin embargo, existe una paradoja.
Nunca ha habido tantos enfoques transversales, pero muchas veces su impacto real sigue siendo limitado.
La pregunta clave ya no es si estos enfoques son importantes.
La evidencia muestra claramente que lo son.
La verdadera pregunta es otra:
¿Cómo integrarlos sin convertirlos en agendas paralelas?
Dentro de nuesta serie «colaboración«, hemos vuelto una y otra vez sobre la colaboración. No porque sea un tema de moda, sino porque sigue siendo un problema no resuelto. Colaborar aparece como condición necesaria para abordar problemas complejos, pero rara vez ocurre de forma sostenida, efectiva y transformadora (Rodríguez-Ariza, 2018).
Con el paso de los años, la serie sobre colaboración ha ido acumulando aprendizajes, frustraciones y patrones recurrentes. Leídos en conjunto, estos textos muestran algo importante: la colaboración no falla por falta de intención, sino por diseño deficiente de los sistemas en los que se espera que ocurra.
Este post propone una síntesis de esos patrones —conductores y barreras— conectándolos con la literatura clásica sobre acción colectiva y sistemas complejos.